Simple OLS and Properties of Estimators
Large N & Leeuwenhoek (70700173)
Yue Hu
Overview
- Road to OLS
- OLS Components
1 Road to OLS
1.1 Where are We
Goal: Understanding data patterns in terms of random variable
Path through
- Probability theory
- PDF/CDF
- Confidence intervals/p-values
- Description
- Single: Moments
- Relation: Association
- Hypothesis testing
- Hypothesis setup
- Statistical inference
Path forward
Linear (OLS)
- Simple linear regression
- Multiple regression
↓
Generalized linear
- MLE(Binary/Ordered/Nominal)
↓
Nonlinear
- Moderation (& mediation)
1.2 Review: Expectation
\[\begin{align} E(X)_{disc.} =& \sum^n_{i = 1} X_if(X_i).\\ E(X)_{cont.} =& \int^{+\infty}_{-\infty}X_if(X_i)dX,\\ =& \mu.\\ \sigma^2 =& E[X - E(X)]^2, \\ =& E[(X - \mu)^2],\\ =& E(X^2 - 2X\mu + \mu^2),\\ =& E(X^2) - 2\mu E(X) + \mu^2,\\ =& E(X^2) - \mu^2. \end{align}\]
\[\begin{align} cov(X, Y) =& \sum(X - \mu_X)(Y - \mu_Y)p(X, Y),\\ =& E[X - E(X)][Y - E(Y)],\\ =& E[XY - X\cdot E(Y) -\\ &Y\cdot E(X) + E(X)E(Y)],\\ =& E(XY) - E(Y)E(X) -\\ &E(X)E(Y) + E(X)E(Y),\\ =& E(XY) - E(X)E(Y). \end{align}\]
1.3 Review (Continued): Variance
\[\begin{align} var(aX + b) =& E[(aX + b) - E(aX + b)]^2 = E[aX - aE(X)]^2, \\ =& a^2E[X - E(X)]^2 = a^2var(X). \end{align}\]
\[var(aX_1 + bX_2+ c) = a^2var(X_1) + b^2var(X_2) + 2ab\cdot cov(X_1, X_2).\]
When Xi is i.i.d., \[var(a_1X_1 + a_2X_2 + ... + a_nXn) = var(\sum a_iX_i) = \sum a_i^2var(X_i).\]
\[var(\bar X) = var(\frac{\sum X_i}{n}) = \sum^n_{i = 1}\frac{var(X_i)}{n^2} = \frac{n\sigma^2}{n^2} = \frac{\sigma^2}{n}\]
Comparison of deviation measurements
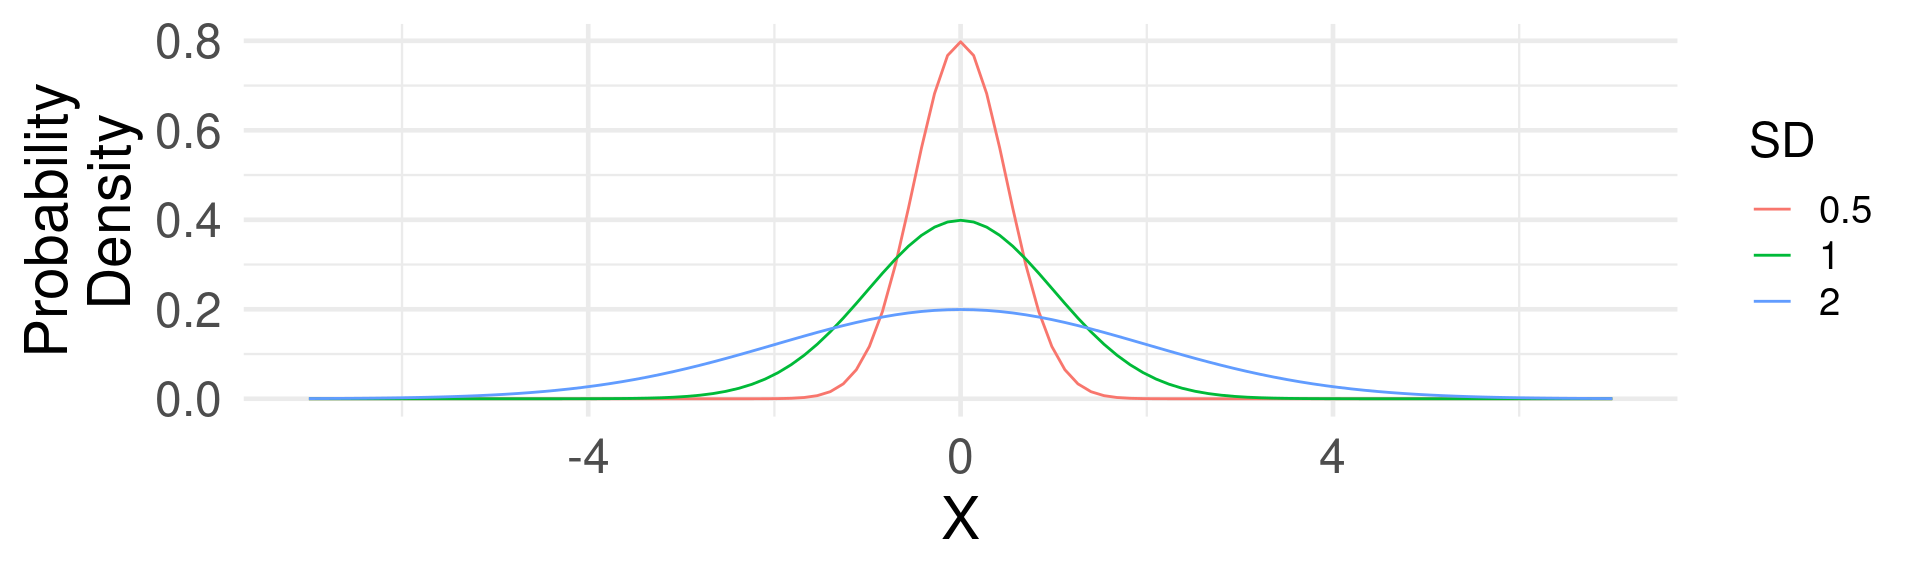
Pop: \(\sigma^2 = \frac{\sum (X_i - \mu)^2}{N}\); Sample: \(s^2 = \frac{\sum (X_i - \bar{X})^2}{\color{darkred}{n - 1}}\); Sample means: \(\text{Var}(\bar{X}) = \frac{\sigma^2}{n}\); \(\text{SE}(\bar{X}) = \frac{\sigma}{\sqrt{n}}.\)
1.4 Review (Continued): Property of a good estimator \(\hat \theta\)
- Unbiased: On average, the estimator gives the right answer, formally, \(E(\hat\theta) = \theta.\)
- Consistent: As the sample size increases, the variance decreases.
- Efficiency: Smallest variance among unbiased estimators1
1.5 Ordinary Least Squares (OLS)
One type of simulation of the reality among many others (unnecessarily the best one).


Important
Interpretation: How does variable Y change on average when some explanatory variable X changes (while the others don’t)?
2 OLS Component
2.1 Linearity
Which X has the linear relationship with Y?
\[\begin{align} Y_i =& \beta_0 + \beta_1X_i + \epsilon_i;\\ Y_i =& \frac{1}{\beta_0} + \frac{X_i}{\beta_1} + \epsilon_i;\\ Y_i =& \beta_0 + \beta_1ln(X_i) + \epsilon_i;\\ Y_i =& \beta_0 + \frac{\beta_1}{X_i} + \epsilon_i;\\ Y_i =& \beta_0 + X_i^{\beta_1} + \epsilon_i.\\ \end{align}\]
2.2 OLS Formally1
\[\begin{align} Y_i =& \beta_0 + \beta_1X_1 + \epsilon_i.\\ E(Y_i|X_i) =& E(\beta_0 + \beta_1X_1 + \epsilon_i|X_i),\\ =& E(\beta_0|X_i) + E(\beta_1X_1|X_i) + E(\epsilon_i|X_i),\\ =& \beta_0 + \beta_1X_i + E(\epsilon_i|X_i). \end{align}\]
&epsiloni: Things we can’t explain but hope to be zero.
Sample Regression Function (SRF)
\[\begin{align} Y_i =& (\hat\beta_0 + \hat\beta_1X_i) + \hat \epsilon_i,\\ =& \hat Y_i + \hat \epsilon_i.\\ =& E(Y_i|X_i) + \epsilon_i,\\ \Leftrightarrow \epsilon_i =& Y_i - E(Y_i|X_i). \end{align}\]
2.3 Minimizing Sum of Squares

2.4 A Good Estimator → Minimizing Expected \(\epsilon\)
β0 and β1 that make \(\sum[Y_i - (\hat\beta_0 + \hat\beta_1X_i)]^2 = 0\)
\[\begin{align} \frac{\partial\sum[Y_i - (\hat\beta_0 + \hat\beta_1X_i)]^2}{\partial\hat\beta_1} = -\sum 2X_i(Y_i - \hat\beta_0 - \hat\beta_1X_i) =& 0;\\ \Leftrightarrow \sum X_iY_i - \sum X_i\hat\beta_0 - \sum\hat\beta_1 X_1^2 =& 0;\\ (\sum X_iY_i =& \sum X_i\hat\beta_0 + \sum\hat\beta_1 X_1^2);\\ \sum X_iY_i - \sum X_i(\bar Y - \hat\beta_1\bar X) - \sum\hat\beta_1 X_1^2 =& 0;\\ \sum X_iY_i - \sum X_i\bar Y + \sum X_i\hat\beta_1\bar X - \sum\hat\beta_1 X_1^2 =& 0;\\ \sum X_i(Y_i - \bar Y) + \hat\beta_1\sum X_i(\bar X - X_i) =& 0;\\ \sum X_i(Y_i - \bar Y) =& \hat\beta_1\sum X_i(X_i - \bar X);\\ \hat\beta_1 =& \frac{\sum X_i(Y_i - \bar Y)}{\sum X_i(X_i - \bar X)}. \end{align}\]
A transformation gadget:
\[\begin{align} \sum X_i(Y_i - \bar Y) =& \sum X_i(Y_i - \bar Y) - \bar X(n\bar Y - n\bar Y)\\ =& \sum X_i(Y_i - \bar Y) - \bar X(\sum Y_i - \sum\bar Y)\\ =& \sum X_i(Y_i - \bar Y) - \bar X\sum (Y_i - \bar Y)\\ =& \sum (X_i - \bar X)(Y_i - \bar Y) \blacksquare \end{align}\]
\[\begin{align} \hat\beta_1 =& \frac{\sum X_i(Y_i - \bar Y)}{\sum X_i(X_i - \bar X)}, \text{using the above}\\ \hat\beta_1 =& \frac{\sum (X_i - \bar X)(Y_i - \bar Y)}{\sum (X_i - \bar X)^2}. \end{align}\]
2.5 \(\beta_1\)
\[\begin{align} \hat\beta_1 =& \frac{\sum (X_i - \bar X)(Y_i - \bar Y)}{\sum (X_i - \bar X)^2},\\ =& \frac{\sum (X_i - \bar X)(Y_i - \bar Y)}{\sqrt{\sum (X_i - \bar X)^2}\color{darkred}{\sqrt{\sum (Y_i - \bar Y)^2}}}\cdot\frac{\color{darkred}{\sqrt{\sum (Y_i - \bar Y)^2}}}{\sqrt{\sum (X_i - \bar X)^2}},\\ =& r_{X, Y}\frac{s_Y}{s_X}. \end{align}\]
Tip
So, when the variance of Y(sY) increases, β1 increases.
A special case: Standardized X and Y, i.e., \(s_Y, s_X\) are 1s, then,
\[\beta_1 = r_{X, Y}\frac{s_Y}{s_X} = r_{X,Y}.\]
2.6 Linear nature of the OLS coefficient1
\[\begin{align} \hat\beta_1 =& \frac{\sum (X_i - \bar X)(Y_i - \bar Y)}{\sum (X_i - \bar X)^2},\\ =& \frac{1}{\sum (X_i - \bar X)^2}\sum (X_i - \bar X)Y_i,\\ =& \frac{1}{\sum (X_i - \bar X)^2}\sum (X_i - \bar X)(\beta_0 + \beta_1X_i + \epsilon_i),\\ =& \frac{1}{\sum (X_i - \bar X)^2}[\sum (X_i - \bar X)(\beta_0 + \beta_1X_i) + \sum (X_i - \bar X)\epsilon_i],\\ =& \frac{\sum (X_i - \bar X)(\beta_0 + \beta_1X_i)}{\sum (X_i - \bar X)^2} + \frac{\sum (X_i - \bar X)\epsilon_i}{\sum (X_i - \bar X)^2}. \end{align}\]
Let \(k_i=\frac{X_i - \bar X}{\sum (X_i - \bar X)^2},\) then \(\hat\beta_1 = \sum k_i\beta_0 + \sum k_i X_i\beta_1 + \sum k_i\epsilon_i.\)
- A linear combination with errors
- Min/max(X) influences a lot.
2.7 Var(\(\beta_1\))
\(\hat\beta_1 = \sum k_i\beta_0 + \sum k_i X_i\beta_1 + \sum k_i\epsilon_i.\)
\[\begin{align} \sigma^2 =& var(\epsilon_i|X),\\ =& var(Y_i - \hat\beta_0 - \hat\beta_1X|X),\\ =& \frac{\sum(\hat \epsilon_i^2)}{n - 2},\\ =& \hat\sigma^2. \end{align}\]
\[\begin{align} var(\hat \beta_1|X) =& var(\frac{\sum(X_i - \bar X)(Y_i - \bar Y)}{\sum(X_i - \bar X)^2}|X)\\ =& var(\beta_1 + \sum k_i\epsilon_i|X)\\ =& var(\sum k_i\epsilon_i|X), \text{given}\ \beta_1\sum k_iX_i \text{constant}\\ =& \sum var(k_i\epsilon_i|X), \text{assuming}\ \epsilon_i\ \text{independent}\\ =& \sum k_i^2 var(\epsilon_i|X)\\ =& \sum[\frac{X_i - \bar X}{\sum (X_i - \bar X)^2}]^2\sigma^2\\ =& \frac{\sum(X_i - \bar X)^2}{[\sum (X_i - \bar X)^2]^2}\sigma^2 = \frac{\sigma^2}{\sum (X_i - \bar X)^2} \end{align}\]
Assumption is IMPORTANT!!!
If εi is not independent, then cov(k, ε) > 0, and this estimator is underestimated.
2.8 \(\beta_0\)
\[\begin{align} \frac{\partial\sum[Y_i - (\hat\beta_0 + \hat\beta_1X_i)]^2}{\partial\hat\beta_0} =& -\sum 2(Y_i - \hat\beta_0 - \hat\beta_1X_i) = 0\\ \Leftrightarrow\sum Y_i - \sum\hat\beta_0 - \sum\hat\beta_1X_i =& 0\\ \sum Y_i =& \sum\hat\beta_0 + \sum\hat\beta_1X_i\\ =& n\hat\beta_0 + \hat\beta_1\sum X_i\\ \hat\beta_0 =& \frac{\sum Y_i}{n} - \hat\beta_1\frac{\sum X_i}{n} = \bar Y - \hat\beta_1\bar X \end{align}\]
Normal equations
\[\begin{align} \sum Y_i =& n\hat\beta_0 + \hat\beta_1\sum X_i\\ \sum X_iY_i =& \sum X_i\hat\beta_0 + \sum\hat\beta_1 X_1^2 \end{align}\]
2.9 Var(\(\beta_0\))
\[\begin{align} var(\hat \beta_0|X) =& var(\bar Y - \hat\beta_1\bar X|X),\\ =& var[\frac{\sum(\beta_0 + \beta_1X_i + \epsilon_i)}{n} - \hat\beta_1\bar X|X],\\ \because \beta_0 +& \beta_1X_i\text{ is constant & independent},\\ =& var(\frac{\sum \epsilon_i}{n}|X) + var(\hat\beta_1\bar X|X), \\ =& var(\frac{\sum \epsilon_i}{n}|X) + var(\hat\beta_1\bar X|X) = \frac{var(\sum \epsilon_i|X)}{n^2} + \bar X^2var(\hat\beta_1|X),\\ =& \frac{n\sigma^2}{n^2} + \frac{\bar X^2\sigma^2}{\sum (X_i - \bar X)^2} = \sigma^2[\frac{1}{n} + \frac{\bar X^2}{\sum (X_i - \bar X)^2}],\\ =& \sigma^2[\frac{\sum (X_i - \bar X)^2 + n\bar X^2}{n\sum (X_i - \bar X)^2}] = \sigma^2[\frac{\sum X_i^2 - \sum\bar X^2 + n\bar X^2}{n\sum (X_i - \bar X)^2}],\\ =& \sigma^2[\frac{\sum X_i^2 - n\bar X^2 + n\bar X^2}{n\sum (X_i - \bar X)^2}]= \sigma^2\frac{\sum X_i^2}{n\sum (X_i - \bar X)^2}. \end{align}\]
2.10 Characteristics of OLS Coefficients
- Calculated using observed data
- Unique point estimates
- SRF passes through \((\bar X, \bar Y)\)
- \(\bar{\hat Y} (\text{predicted}) = \hat Y (\text{observed})\), \(\frac{\sum\hat Y_i}{n} = \frac{\sum Y_i}{n}\)
- \(\bar{\hat \epsilon_i} = \frac{\sum{\hat \epsilon_i}}{n} = 0\)
- \(\sum X_i\hat \epsilon_i = 0\)
\[\begin{align} cov(X_i, \epsilon_i) =& 0,\\ \frac{\sum(X_i - \bar X)(\hat \epsilon_i - \bar{\hat \epsilon_i})}{n-1} =& 0,\\ \frac{\sum X_i\hat \epsilon_i}{n-1} =& 0. \blacksquare \end{align}\]
2.11 Take-home point

Appendix
Stretch
Meditation
